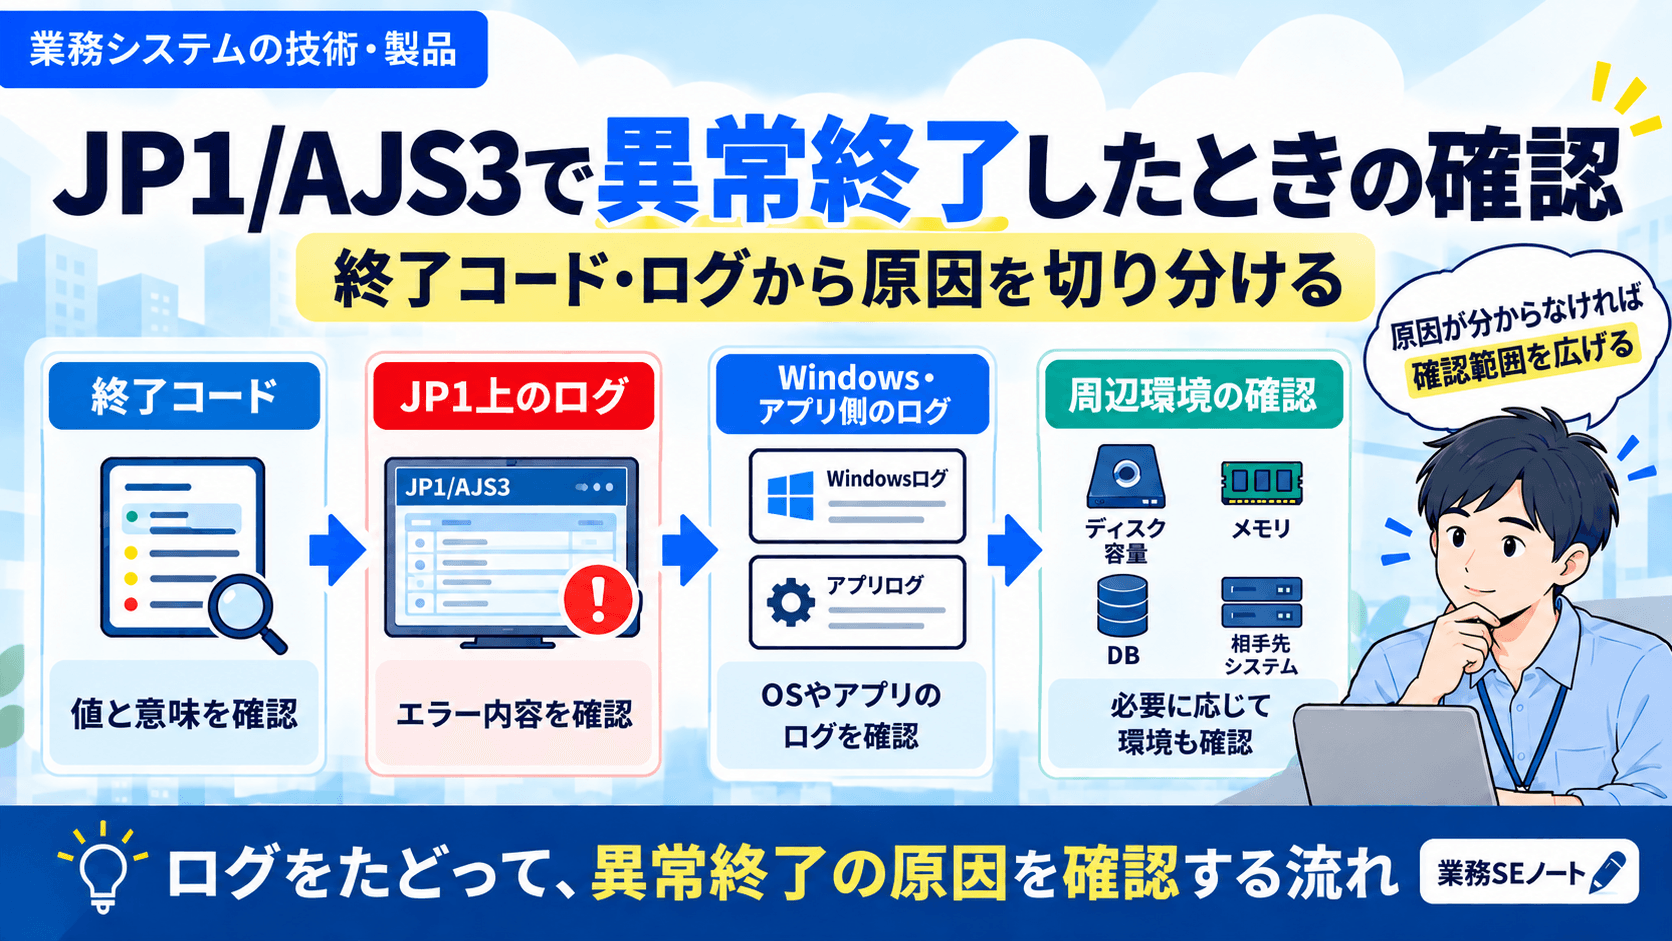
JP1/AJS3でジョブが異常終了したとき、私が最初に確認していたのは終了コード(処理が終わったときに返される数値)とJP1/AJS3の画面に表示されるログでした。
そこで原因が分からなければ、JP1/AJS3以外のログや周辺環境まで確認範囲を広げていました。
この記事では、ジョブが異常終了したときにどこを確認し、どのように原因を絞っていたのかを、実務経験から紹介します。
JP1/AJS3のジョブとジョブネットの関係については、JP1/AJS3のジョブネットとは?ジョブとの違いを元アプリSEの実務経験から紹介で紹介しています。
終了コードの扱いは処理ごとに違っていた
私が担当した環境では、終了コードの扱いは処理ごとに同じではありませんでした。
例えば、
- 0なら正常
- 1なら異常ではあるが後続処理へ進める
- それ以外なら異常として後続を止める
といった判定をしている処理もありました。
これは私が担当した環境での一例で、JP1/AJS3全体で同じ終了コードを使うという意味ではありません。
現在の日立製作所「JP1/Automatic Job Management System 3 設計ガイド(業務設計編)Version 13」には、標準ジョブなどの終了判定で、ジョブ終了時の戻り値と警告しきい値・異常しきい値を使って正常終了・警告終了・異常終了を判定する方法が記載されています。
日立製作所「JP1/Automatic Job Management System 3 設計ガイド(業務設計編)Version 13」
現在の製品仕様についての補足であり、上で挙げた「0、1、それ以外」という例は、当時私が担当した環境での運用経験です。
JP1/AJS3で異常終了していても原因は別にあることが多かった
私が担当した環境では、JP1/AJS3上でジョブが異常終了していても、原因そのものがJP1/AJS3ではないことが多くありました。
正確に集計した数字ではありませんが、私の経験上の感覚では、8割前後はJP1/AJS3自体が原因ではありませんでした。
実際に経験したものには、
- ディスク容量の問題
- フォルダが消去されていた
- DBデータの内容に問題があった
- 相手先システムが停止していた
といった原因がありました。
直前の正常ログと時刻から止まった場所を見ていた
ログを見るときは、エラーが出た箇所だけではなく、直前の正常ログも確認していました。
どこまで正常なログが出ているかを見て、どの処理までは動いていたのかを確認していました。
また、直前の正常ログとエラーが発生した時刻の時間差から、どの処理でエラーになったのかを推測することもありました。
エラーコードやエラー詳細から原因が分かる場合もあれば、対象データの中身を確認して分かる場合もありました。
JP1/AJS3だけで分からなければWindowsやアプリ側も確認していた
JP1/AJS3の終了コードや画面上のログだけでは原因が分からない場合は、Windows側のログやアプリ側のログへ確認範囲を広げていました。
必要に応じて、ディスクやメモリも一応確認していました。
原因を確認した後にどこまで処理を止めるか、どこから再実行するかについては、システムのエラーハンドリングで何を考えていた?停止・通知・再実行の実務経験で紹介しています。
複数回起きたエラーは手順書化や自動化されることもあった
同じエラーが複数回起きると、私が担当した環境では、次第に想定済みのエラーとして扱われるものもありました。
そうしたエラーでは、対処方法が手順書になったり、対応自体が自動化されたりすることがありました。
最初からすべてのエラーが想定されていたという意味ではなく、繰り返し発生する中で既知のエラーになっていったものです。
一番困ったのはログに何も出ていないエラーだった
原因確認で特に面倒だったのは、ログに何も出ていないエラーでした。
エラーコードや詳細が出ている場合は、そこから確認を進められます。
一方、ログに原因につながる情報が何も出ていないと、どこに原因があるのか分からず、私が経験した中では特に切り分けが難しいケースでした。