システム障害が発生したときは、影響を確認しながら復旧に向けた対応が必要になります。
ただ、実際の障害対応は、復旧できればそこで終わりとは限りません。
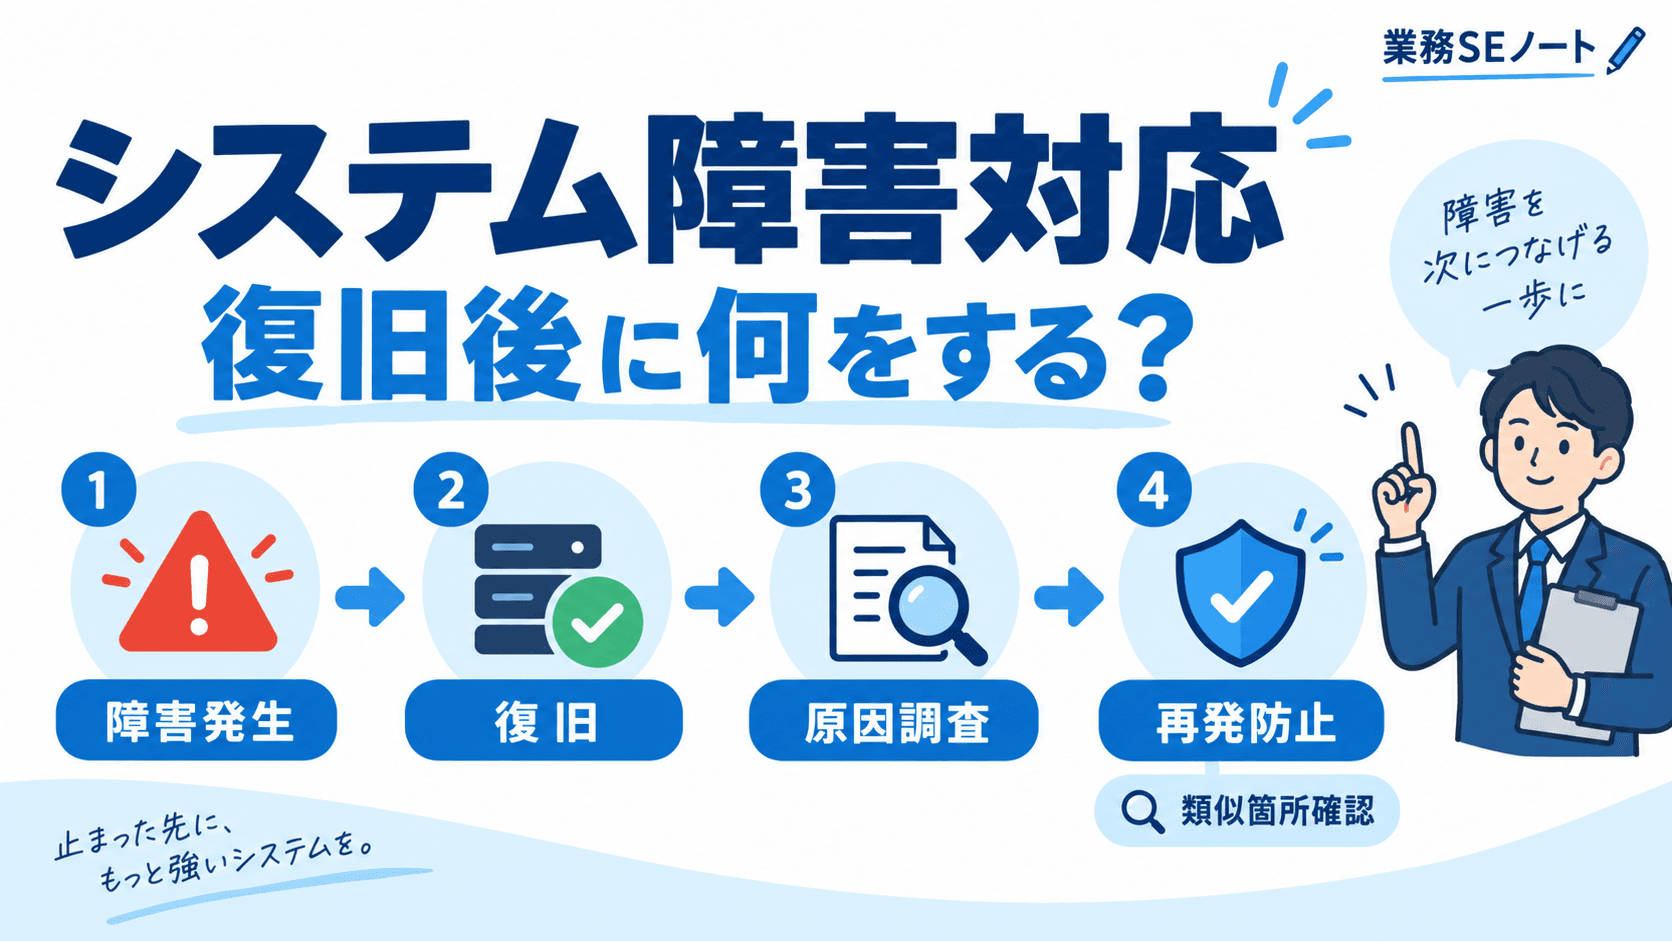
私はアプリSEとして障害対応を経験しましたが、復旧後には原因を調べ、再発防止策を考え、必要に応じて類似する箇所も確認していました。
初めて障害対応をしたときは強く緊張しましたが、実務で特に大変だと感じたのは、むしろ復旧したあとの対応でした。
この記事では、システム障害が発生したあとにどのような対応が続くのか、私の実務経験と一般的な障害対応の考え方を分けながら紹介します。
なお、障害対応の手順や役割分担は、システムや会社、障害の内容によって異なります。ここで紹介する内容を、すべての現場に共通する固定的な手順として扱うものではありません。
障害発生中は復旧に向けて対応する
障害が発生している間は、影響を確認しながら、システムやサービスを利用できる状態へ戻すための対応が必要になります。
ただし、実際に何を優先するかは、障害の内容や影響範囲によって変わります。
サービスを停止するのか。
一部の機能だけを止めるのか。
復旧作業を行うのか。
こうした判断は、現場ごとの障害対応手順や責任者の判断に従う必要があります。
復旧後に障害の原因を調べる
システムが復旧したあとには、なぜ障害が発生したのかを調べます。
ここで注意したいのは、
「復旧できたから、原因への対応も終わった」
とは限らないことです。
IPAの「情報処理システム高信頼化教訓活用ガイドブック(ITサービス編)」では、障害が起きた場合に、直接障害があった箇所を修正するだけで終わってしまう傾向がある一方、直接原因だけでなく根本的な原因への対策を立てることの重要性が示されています。
IPA「情報処理システム高信頼化教訓活用ガイドブック(ITサービス編)」
また、IPAの「情報処理システム高信頼化教訓集(ITサービス編)別冊Ⅱ:障害分析手法」では、発生した問題事象から原因をたどり、根本原因まで分析する考え方が紹介されています。
私が実務で障害対応を経験したときも、復旧後の原因究明は大変な作業でした。
原因が分かったら再発防止を考える
原因を調べたあとは、同じ障害を繰り返さないための対策を検討します。
単に、
「今回はこの方法で復旧できた」
という対処方法だけを残しても、障害そのものを防げるとは限りません。
原因に応じて、
- システムを修正する
- 設定を見直す
- 手順を見直す
- 確認方法を追加する
など、必要な対応は変わります。
これは特定の再発防止策を必ず行うという意味ではなく、原因に応じて対策を考えるということです。
IPAの「別冊Ⅱ:障害分析手法」でも、なぜなぜ分析の目的の一つとして、根本原因を明らかにして同一障害や類似障害の再発を防止する考え方が示されています。
障害が直ったことと、同じ障害が起きないよう対策できたことは別だと感じた部分です。
類似する箇所も確認していた
私の経験では、原因となった箇所だけを直して終わりではなく、同じような問題がほかの箇所にもないか確認することがありました。
たとえば、ある処理で問題が見つかった場合、
「同じような作りになっている処理はほかにないか」
という観点で確認します。
これは、すべての障害で必ず同じ範囲を確認するという意味ではありません。
IPAの「別冊Ⅱ:障害分析手法」でも、同一障害だけでなく類似障害の発生を防ぐために根本原因を解消する考え方が示されています。
一つの障害を直したあとに、別の場所で同じ問題が起きる可能性まで考えることは、復旧後の対応で大変だった部分の一つです。
まとめ:障害対応は復旧後の原因調査と再発防止まで考える
システム障害が発生したときは、まず目の前で起きている障害への対応が必要になります。
ただし、復旧できたからといって、障害対応がすべて終わるわけではありません。
復旧後には原因を調べ、その原因に応じた再発防止策を検討します。
私が経験した現場では、さらに同じような問題がほかの箇所にもないか確認することもありました。
障害対応を経験して特に印象に残っているのは、復旧そのものだけではなく、その後に原因を突き止め、同じ障害や類似する問題を繰り返さないための対応まで必要だったことです。